Domain deltamethrin.de kaufen?
Wir ziehen mit dem Projekt
deltamethrin.de um.
Sind Sie am Kauf der Domain
deltamethrin.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain deltamethrin.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:



-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Wie funktionieren Webcrawler und welche Vorteile bieten sie für die Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Informationen von Websites sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und in Suchmaschinen verfügbar zu machen. Dadurch wird die Auffindbarkeit von Websites verbessert und die Aktualität der Suchergebnisse gewährleistet. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
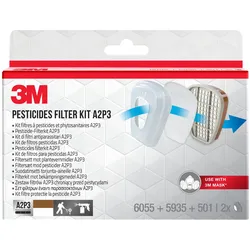
3M, Atemschutzmaske, Pestizid (A2P3)Die 3M Atemschutzmaske ist speziell für den Einsatz in Umgebungen konzipiert, in denen der Schutz vor schädlichen Dämpfen und Partikeln erforderlich ist. Sie bietet eine effektive Barriere gegen öl- und wasserbasierte Dämpfe sowie organische Gase, einschliesslich Pestiziden. Dank des Doppel-Einatemventils wird der Atemwiderstand verringert, was die Atmungsaktivität im Vergleich zu herkömmlichen Einzelfiltern verbessert. Die leichte Bauweise und die ausgewogene Gewichtsverteilung sorgen für hohen Tragekomfort, auch bei längeren Einsätzen. Die trapezförmige Form der Maske gewährleistet ein optimales Sichtfeld, während die Kompatibilität mit 3M Augen- und Gehörschutzprodukten zusätzlichen Schutz bietet. Diese Atemschutzmaske erfüllt die europäischen Normen und ist für den professionellen Einsatz geeignet. - Doppel-Einatemventil für verbesserte Atmungsaktivität - Leicht und mit niedrigem Atemwiderstand - Trapezförmige Form für optimales Sichtfeld - Schutz vor organischen Gasen und Feinstaub.204,03 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
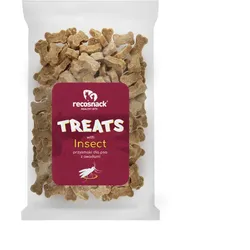
RECOSNACK Schädlingsbekämpfung 20gRECOVET Recosnack Hundeleckerli mit Insekten 20g gesunde Leckerlis nahrhafte Proteinquelle frei von Zucker und Farbstoffen Analytische Zusammensetzung: Protein: 32%, Fettgehalt: 8%, Rohasche: 13%, Rohfaser: 2%, Feuchtigkeitsgehalt: 17%.2,70 €*Versand: 10,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
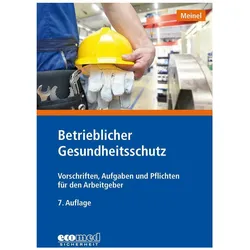
Betrieblicher Gesundheitsschutz, Fachbücher von Hubert MeinelDieses Buch bietet in der beruflichen Praxis die notwendige Unterstützung, um den Rechten und Pflichten im Rahmen des betrieblichen Arbeits- und Gesundheitsschutzes richtig nachzukommen. Die Vorschriften werden entsprechend der Wertigkeit und Hierarchie verständlich und kurz dargestellt, auf Besonderheiten wird aufmerksam gemacht, und Hinweise für den praktischen Umgang werden gegeben. Querverweise vermitteln das zusammenhängende Verständnis. Aufgrund der knappen und übersichtlichen Darstellung sind die Inhalte leicht und schnell erfassbar. Aus dem Inhalt: - Gesetzliche Grundlagen des Arbeits- und Gesundheitsschutzes - Staatliche Festlegungen zum Arbeits- und Gesundheitsschutz - Die Berufsgenossenschaften als Träger der gesetzlichen Unfallversicherung - Organisation des betrieblichen Arbeits- und Gesundheitsschutzes (Aufgaben und Pflichten) - Mitwirkung der Personalvertretung - Betriebsärztliche Tätigkeit und Berufsrecht - Infektionsschutz und Impfungen - Mutterschutz - Jugendarbeitsschutz - Berufskrankheiten - Persönliche Schutzausrüstungen - Betriebliches Gesundheits- und Wiedereingliederungsmanagement.39,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Schroll, Stefan: Arbeits-, Umwelt- und GesundheitsschutzArbeits-, Umwelt- und Gesundheitsschutz , Mehr als 100 klausurtypische Aufgaben und Lösungen , Batteriemanagementsysteme (BMS) > Batterien, BMS & Brennstoffzellen , Auflage: 3., aktualisierte, Erscheinungsjahr: 20210716, Produktform: Kassette, Inhalt/Anzahl: 1, Inhalt/Anzahl: 1, Titel der Reihe: Klausurentraining Weiterbildung - für Betriebswirte, Fachwirte, Fachkaufleute und Meister##, Autoren: Schroll, Stefan, Edition: NED, Auflage: 21003, Auflage/Ausgabe: 3., aktualisierte, Seitenzahl/Blattzahl: 188, Keyword: Industriemeister; Klausuraufgaben; Klausurentraining; Kiehl; Weiterbildung; Arbeitssicherheit; Arbeitsschutz; AUG; Gefahrstoffe; Lagerhaltung; Logistik; Prüfung; Umweltschutz, Fachschema: Jurisprudenz~Recht / Rechtswissenschaft~Rechtswissenschaft, Fachkategorie: Unterricht und Didaktik: Berufsausbildung~Unterricht und Didaktik: Lehrbücher, Region: Deutschland, Bildungszweck: für die Berufsbildung~Für die Erwachsenenbildung: Zwischenstufen, Warengruppe: HC/Berufsschulbücher, Fachkategorie: Berufsausbildung, Thema: Verstehen, Text Sprache: ger, Sender’s product category: BUNDLE, Verlag: Kiehl Friedrich Verlag G, Verlag: Kiehl Friedrich Verlag G, Verlag: NWB Verlag GmbH & Co. KG, Blätteranzahl: 188 Blätter, Länge: 224, Breite: 157, Höhe: 12, Gewicht: 300, Produktform: Kartoniert, Genre: Schule und Lernen, Genre: Schule und Lernen, Beinhaltet: B0000049352001 B0000049352002, Vorgänger EAN: 9783470100227 9783470100210, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, Unterkatalog: Schulbuch,22,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
-
Wie funktionieren Webcrawler und welche Vorteile bieten sie für die Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Informationen von Websites sammeln. Sie folgen Links von einer Seite zur nächsten, um Inhalte zu indexieren und in Suchmaschinen verfügbar zu machen. Dadurch wird die Auffindbarkeit von Websites verbessert und die Aktualität der Suchergebnisse gewährleistet. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.